Urban walkability through different lenses: A comparative study of GPT-4o and human perceptions
Item
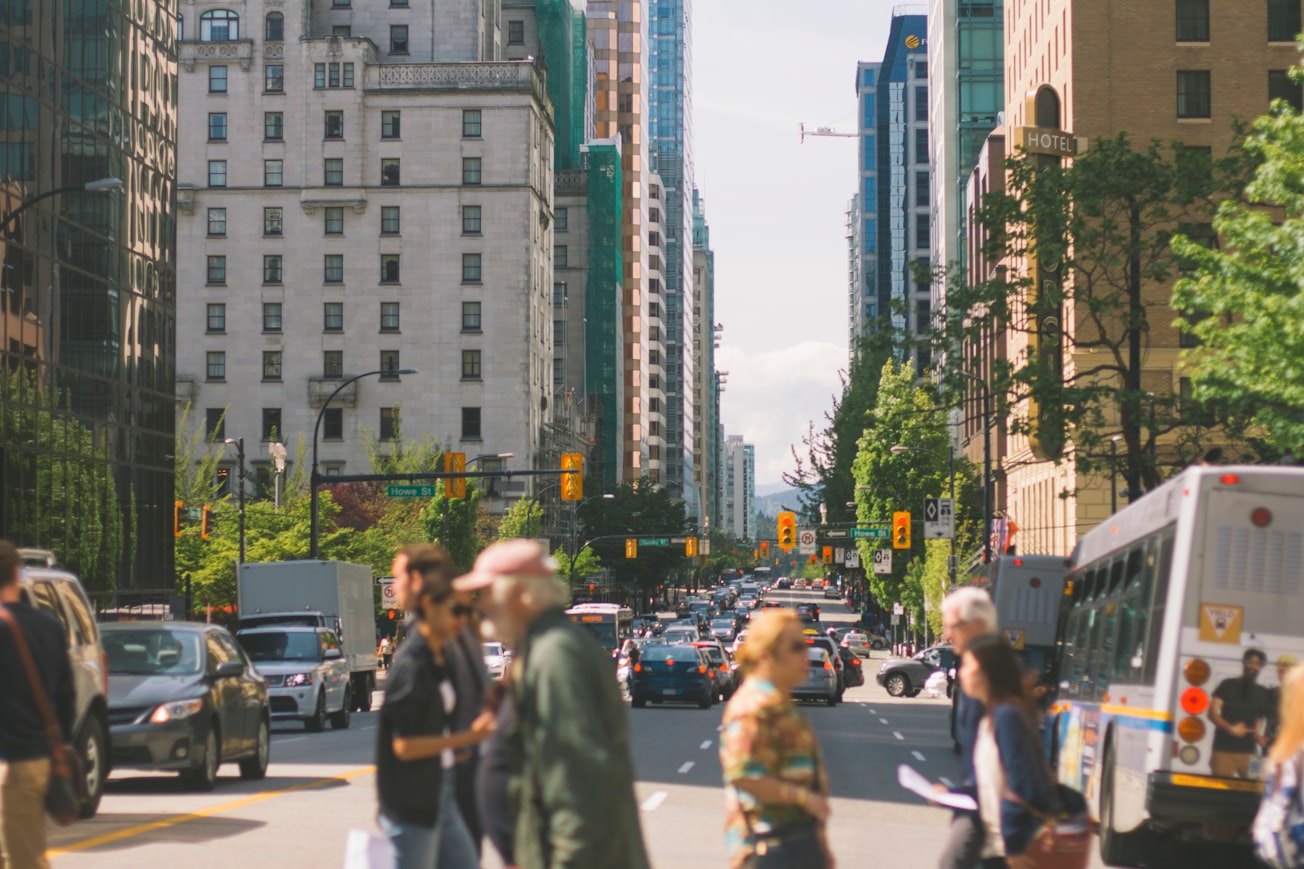
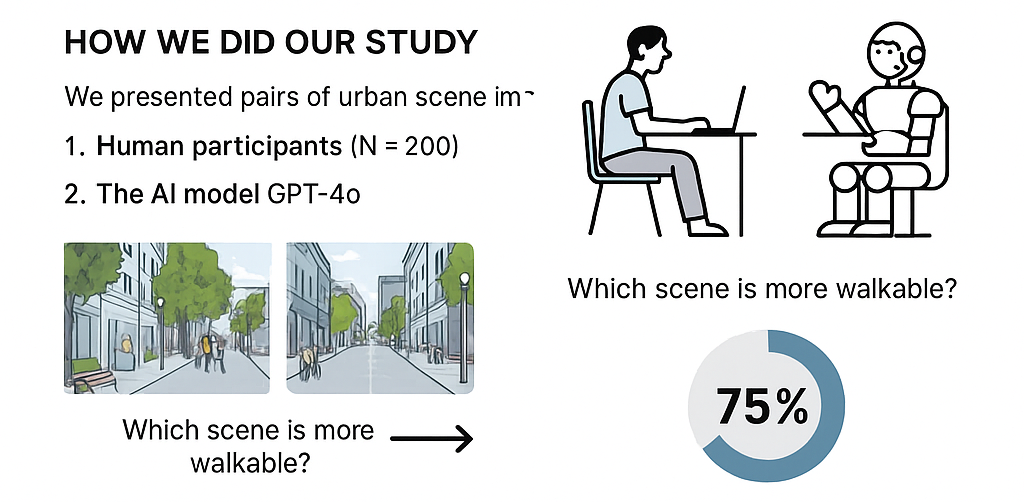
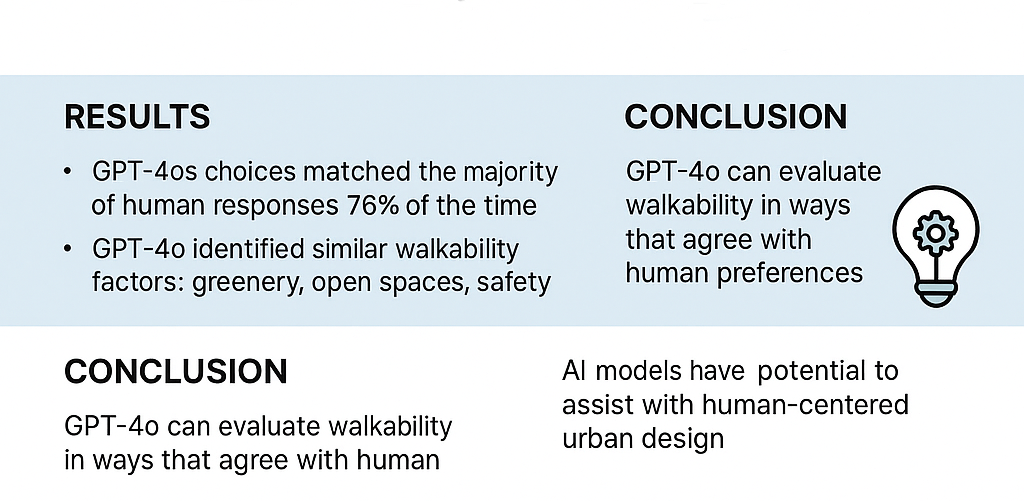
- Title
- Urban walkability through different lenses: A comparative study of GPT-4o and human perceptions
- Genre du récit
- Architecture et espace urbain
- Date de création
- 2025-04-29
- Synopsis du récit artistique
-
L'étude pose une question particulièrement pertinente pour une recherche sur IA, perception et espace urbain: est-ce qu'un modèle multimodal comme GPT-4o peut « lire » un environnement urbain d'une manière comparable à un être humain ?
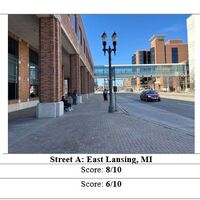
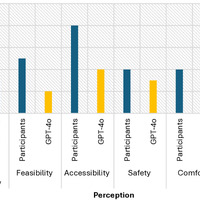
Les chercheurs confrontent directement deux regards sur les mêmes scènes urbaines: celui de participants humains et celui de GPT-4o. Ils leur demandent d'évaluer des photographies de rues selon six dimensions: marchabilité globale, faisabilité, accessibilité, sécurité, confort et liveliness, c'est-à-dire l'animation ou la vitalité perçue de l'espace. L'objectif n'est donc pas simplement de vérifier si l'IA reconnaît un trottoir, un arbre ou une voiture, mais de voir si elle produit une interprétation perceptive du lieu comparable à celle d'un humain.
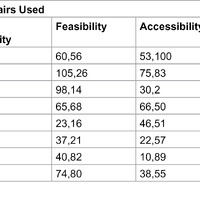
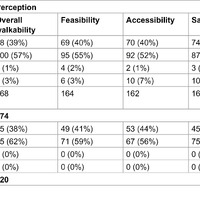
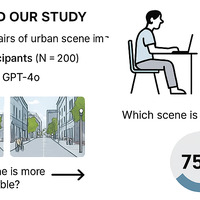
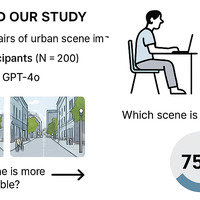
Le dispositif repose sur 48 paires d'images, provenant de Lansing, East Lansing et Williamston dans le Michigan. Les scènes ont été choisies de manière à présenter des environnements contrastés: végétation, densité, circulation, largeur et qualité des espaces piétons, ouverture ou fermeture spatiale, etc. 174 personnes participent à l'enquête. Les mêmes paires sont ensuite soumises à GPT-4o; chaque sollicitation est répétée jusqu'à 15 fois dans des conversations indépendantes afin d'étudier la stabilité du modèle.
Les résultats montrent quelque chose de plus intéressant qu'une simple opposition «humain contre machine». Les évaluations numériques sont souvent proches et aucune différence statistiquement significative n'est trouvée dans les notes globales des deux ensembles d'images. GPT-4o et les humains tendent également à converger pour la marchabilité générale, la faisabilité, l'accessibilité et la sécurité. En revanche, les différences deviennent beaucoup plus importantes lorsqu'il faut évaluer des dimensions expérientielles, notamment le confort et l'animation du lieu. - Artistes principaux, cies
-
 Musab Wedyan
-
 Yu-Chen Yeh
-
 Fatemeh Saeidi-Rizi
-
 Tai-Quan Winson Peng
-
 Chun-Yen Chang
- Crédits complets
-
Crédits complets (taxonomie CRediT déclarée) M. Wedyan : conceptualisation, curation des données, analyse formelle, méthodologie, logiciel, visualisation, rédaction (version initiale, révision).
Y.-C. Yeh: conceptualisation, curation des données, méthodologie.
F. Saeidi-Rizi: conceptualisation, investigation, méthodologie, ressources, supervision, révision.
T.-Q. Peng: analyse formelle, méthodologie.
C.-Y. Chang: méthodologie.
Éditrice académique: Abeer Elshater (Ain Shams University).
Remerciements: HealthScape Lab, Michigan State University. - Intégrer un template Outils
-
 ChatGPT
- Question centrale mis en jeu par l'oeuvre
- Que reste-t-il de l’expérience de la marche urbaine, corporelle, située et affective, lorsqu’elle est convertie en jugement comparatif sur des photographies, puis confiée à un modèle multimodal dont la « perception » n’est validée que par la ressemblance statistique de ses énoncés avec ceux d’humain·es ?
- Position de l'IA/Technologie au sein de l'oeuvre
- L’IA se situe dans le dispositif empirique, pas dans une diégèse fictionnelle. GPT-4o reçoit des paires de photographies choisies par l’équipe, les évalue et génère des justifications. Son autonomie est bornée par les entrées, les questions, les répétitions et le traitement des résultats, tous organisés par les chercheur·euses. Les participant·es produisent leurs propres réponses sans outil IA. Les opérations de comparaison ne sont pas une coécriture littéraire : le modèle fournit un corpus parallèle. Son interface est visible au moment des interrogations, tandis que ses mécanismes internes ne sont pas exposés par le protocole. Le texte parle de perception et d’opinion de façon fonctionnelle ; aucune conscience ni expérience corporelle du modèle n’est démontrée. Il relie l’espace photographié à des critères de marche par des descriptions verbales. La fonction narrative secondaire vient des usages possibles que ces descriptions permettent d’imaginer. Aucune évolution ou formation progressive du modèle n’est rapportée ; c’est l’interprétation de sa place qui évolue, de candidat évaluateur à auxiliaire soumis au jugement humain.
- Intégrer un template Éléments narratifs
-
 La rue possible dans les justifications de préférence
-
 L’IA mise à l’épreuve dans le récit de recherche
- Intégrer un template Analyse critique - Annotation
-
 Évaluer une rue sans en faire l’expérience
-
 La mesure dépend de la question posée
-
 Qui représente la perception humaine?
-
 Une expertise qui doit rester contestable
-
 Des qualités perçues aux décisions d’aménagement
- Contenus scientifiques
-
 Climbing towards NLU: On Meaning, Form, and Understanding in the Age of Data
-
 Situated Knowledges: The Science Question in Feminism and the Privilege of Partial Perspective
-
 To Walk or Not to Walk? The Hierarchy of Walking Need
- listez les concepts et mots-clés
- Approche scientifique
- Architecture
- Calculabilité
- IA générative
- Intelligence artificielle
- Jugement
- LLM
- Perception
- Prompt Engineering
- Relation humain-machine
- Domaines du récit
- Environnement
- Quels sont les enjeux soulevés autour de l'IA ?
- IA comme outil de modélisation et de gestion environnementale
- Quelles sont les promesses et bénéfices soulevées autour de l'IA ?
- Productivité et automatisation des tâches
- Extension des capacités intellectuelles
- Collaboration humain-machine
- Renforcement de la participation citoyenne
- Figures de l'IA
- L'IA comme partenaire
- L'IA comme expert
- L'IA comme double / substitut de l'humain
- Cadrages idéologiques
- Techno-solutionnisme
- Éthique et responsabilité
- Neutralité algorithmique (l'IA présentée comme objective)
- Effets sur le spectateur /public
- Espoir / optimisme
- Ambivalence
- Neutralité / distance critique
- Risques et mises en garde
- Biais algorithmiques et discriminations
- Remise en cause de l'expertise humaine
Linked resources
| Title | Class |
|---|---|
| Des qualités perçues aux décisions d’aménagement |
|
| Évaluer une rue sans en faire l’expérience |
|
| La mesure dépend de la question posée |
|
| Qui représente la perception humaine? |
|
| Une expertise qui doit rester contestable |
Annotations
There are no annotations for this resource.