Large Language Model Influence on Diagnostic Reasoning: A Randomized Clinical Trial
Item
- Titre (article, livre complet, chapitre de livre, publication réseaux sociaux, pageWeb, SiteWeb complet, etc.)
- Large Language Model Influence on Diagnostic Reasoning: A Randomized Clinical Trial
- Auteur de la référence bibliograpique
- Ethan Goh, Robert Gallo, Jason Hom, Eric Strong, Yingjie Weng, Hannah Kerman, Joséphine A. Cool, Zahir Kanjee, Andrew S. Parsons, Neera Ahuja, Eric Horvitz, Daniel Yang, Arnold Milstein, Andrew P. J. Olson, Adam Rodman, Jonathan H. Chen
- Date de publication (AAAA ou AAAA-MM-JJ)
- 2024-10-28
- Résumé
-
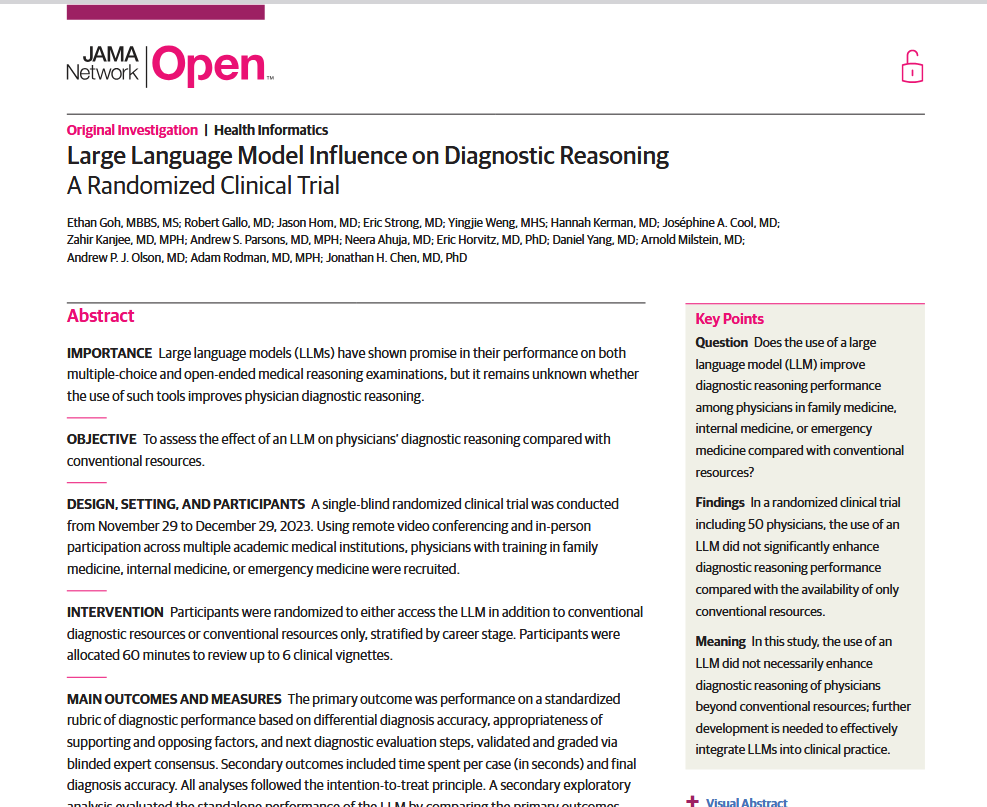
Cet essai clinique randomisé compare le raisonnement diagnostique de médecins ayant accès à un grand modèle de langage à celui de médecins disposant seulement des ressources conventionnelles. L'étude a été menée du 29 novembre au 29 décembre 2023, en visioconférence et en présentiel, auprès de cinquante médecins de famille, internistes et urgentistes recruté·es à l'Université Stanford, au Beth Israel Deaconess Medical Center et à l'Université de Virginie. Le groupe comptait vingt-six médecins traitant·es et vingt-quatre résident·es, avec une médiane de trois années de pratique.
Les participant·es ont été réparti·es aléatoirement entre un groupe ayant accès à ChatGPT Plus, fondé sur GPT-4, en plus des ressources habituelles comme UpToDate et Google, et un groupe restreint à ces seules ressources habituelles. Chaque personne disposait de soixante minutes pour traiter jusqu'à six vignettes cliniques, adaptées d'une étude de référence sur l'évaluation des systèmes diagnostiques informatisés et jamais rendues publiques, de façon à les exclure des données d'entraînement du modèle.
L'indicateur principal est un score de réflexion structurée, adapté de la littérature sur le raisonnement clinique. Plutôt que de mesurer seulement l'exactitude du diagnostic final, la grille évalue le diagnostic différentiel, les éléments qui appuient ou contredisent chaque hypothèse et les prochaines étapes d'investigation. Les correcteur·rices ignoraient quelles copies appartenaient à chacun des deux groupes.
Le score médian par cas s'établit à 76 % dans le groupe avec modèle de langage et à 74 % dans le groupe témoin, soit une différence ajustée de deux points de pourcentage, non significative. Le temps médian passé par cas est de 519 secondes contre 565, différence également non significative. Une analyse secondaire fait apparaître un résultat inattendu : le modèle de langage seul, interrogé sans intervention humaine à partir d'une requête élaborée par l'équipe, obtient un score médian de 92 %, soit seize points de pourcentage de plus que le groupe témoin, différence cette fois significative.
Les auteur·rices concluent que la seule mise à disposition d'un modèle de langage n'améliore pas le raisonnement diagnostique et qu'un travail de développement technologique et de formation de la main-d'œuvre est nécessaire pour réaliser le potentiel de la collaboration entre médecins et intelligence artificielle. Ils avancent plusieurs explications possibles, dont la sensibilité des sorties du modèle à la formulation de la requête et l'absence de formation des participant·es à cet égard. Ils précisent également que les résultats ne doivent pas être interprétés comme un appui à un usage autonome du modèle sans supervision médicale, l'étude étant décontextualisée et les vignettes ayant été rédigées et résumées par des cliniciens.
L'étude a été financée par la Gordon and Betty Moore Foundation, dont l'un des coauteurs, Daniel Yang, était employé pendant sa conduite. Eric Horvitz y figure avec une double affiliation, Microsoft et le Stanford Institute for Human-Centered Artificial Intelligence. L'essai est enregistré sous l'identifiant ClinicalTrials.gov NCT06157944. - Numéro (revues scientifiques)
- 10
- Volume (revues scientifiques)
- 7
- Maison d'édition / Nom de la revue scientifique / Nom du site Web / Nom de l'institution universitaire (thèses) / Institution d'un rapport, etc.
- JAMA Network Open
- Intervalles des pages (articles)
- e2440969
- Nombre de pages (livres)
- 12
- Format, type de document (ex: image, publication textuelle, vidéo, etc.)
- Article en ligne; PDF
- Quel type de publication sur réseau social (ex: statut Facebook, statut Twitter, etc.)
- Article scientifique
- URL (adresse Web)
- https://doi.org/10.1001/jamanetworkopen.2024.40969
- Media
 goh llm.png
Linked resources
| Title | Class |
|---|---|
 RAISE Health Symposium 2025 |
Annotations
There are no annotations for this resource.