Rapid Evaluation of Artificial Intelligence Technology Used for Ambient Dictation in Primary Care: Comparing the Quality of Documentation of Artificial Intelligence–Generated and Human-Produced Clinical Notes
Item
- Titre (article, livre complet, chapitre de livre, publication réseaux sociaux, pageWeb, SiteWeb complet, etc.)
- Rapid Evaluation of Artificial Intelligence Technology Used for Ambient Dictation in Primary Care: Comparing the Quality of Documentation of Artificial Intelligence–Generated and Human-Produced Clinical Notes
- Auteur de la référence bibliograpique
- Ashok Reddy, Eric Gunnink, Chelle L. Wheat, Scott Pawlikowski, Chína M. Payne, Scott Wiltz, Terrence L. Hubert, Susan Kirsh, Evan Carey, Donna Hill et Karin M. Nelson
- Date de publication (AAAA ou AAAA-MM-JJ)
- 2026-04-17
- Résumé
-
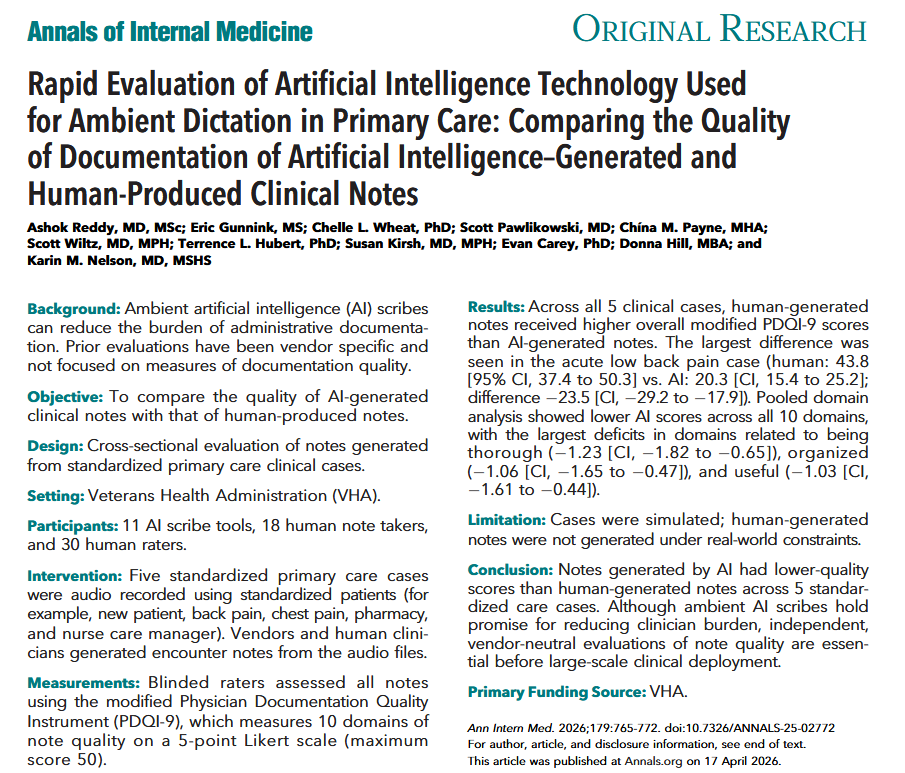
Évaluation transversale indépendante menée par la Veterans Health Administration américaine, comparant la qualité documentaire des notes cliniques produites par onze scribes ambiants à celles rédigées par des personnes.
Cinq cas normalisés de première ligne ont été mis en scène et enregistrés en environnement de simulation : une première visite avec diagnostic de diabète, une lombalgie aiguë, une évaluation de douleur thoracique, une consultation en pharmacie et un suivi d'insuffisance cardiaque avec une infirmière gestionnaire de cas. Des difficultés de captation ont été introduites délibérément : voix à accent non natif aux cas 1 et 4, bruit de fond important au cas 2, port du masque chirurgical au cas 3.
Les onze fournisseurs ont généré une note à partir des mêmes fichiers audio, rejoués dans des conditions contrôlées. Dix-huit personnes soignantes ont produit des notes de comparaison à partir des mêmes enregistrements. Trente évaluateur.rices en exercice ont ensuite coté l'ensemble à l'aveugle, sans savoir quelles notes provenaient d'un système, au moyen d'une version modifiée d'un instrument validé de qualité documentaire mesurant dix dimensions.
Les notes humaines obtiennent des scores supérieurs sur l'ensemble des cinq cas. L'écart le plus marqué concerne la lombalgie avec bruit de fond, où le score moyen passe de 43,8 pour les notes humaines à 20,3 pour celles générées. Le cas avec port du masque montre également un écart significatif. Les deux cas comportant des voix à accent non natif ne montrent pas d'écart significatif, ce qui situe la faiblesse du côté acoustique plutôt que linguistique dans ce protocole.
L'analyse par dimension montre des scores inférieurs pour les notes générées sur les dix dimensions. Les écarts les plus importants portent sur le caractère complet, l'organisation et l'utilité. Les écarts les plus faibles concernent l'absence de biais et l'absence de fabrication.
Les auteur.es concluent que ces outils doivent être considérés comme produisant des projets de documentation à réviser, non comme des substituts aux notes rédigées par une personne. Ils recommandent des évaluations indépendantes et neutres à l'égard des fournisseurs avant tout déploiement à grande échelle, ainsi que des cadres d'assurance qualité continue.
L'article précise que des limitations contractuelles empêchent d'interpréter les résultats pour des fournisseurs identifiés. Les cas étaient simulés et les notes humaines n'ont pas été produites sous les contraintes de temps de la pratique réelle. - Numéro (revues scientifiques)
- 6
- Volume (revues scientifiques)
- 179
- Maison d'édition / Nom de la revue scientifique / Nom du site Web / Nom de l'institution universitaire (thèses) / Institution d'un rapport, etc.
- Annals of Internal Medicine
- Intervalles des pages (articles)
- 765-772
- Nombre de pages (livres)
- 8
- Format, type de document (ex: image, publication textuelle, vidéo, etc.)
- Article en ligne; PDF
- Quel type de publication sur réseau social (ex: statut Facebook, statut Twitter, etc.)
- Article scientifique
- URL (adresse Web)
- https://doi.org/10.7326/ANNALS-25-02772
- Media
 reddy rapid.png
Linked resources
| Title | Class |
|---|---|
 Abridge |
Annotations
There are no annotations for this resource.